Pečecké noviny
Aktualizováno: 16. 9. 2026
Archiv se právě načítá…
Načítám archiv textu…
2026
Nejnovější vydání
2025
2024
2023
2022
2021
2020
Starší ročníky (lokální archiv)
Starší ročníky nejsou v aktuálním online archivu pecky.cz dostupné (rozcestník i dřívější přímé odkazy vrací 404) — čísla níže pochází z lokálně dochovaných kopií, které web doplnil ručně. Chybí listopad 2012, srpen 2015 a leden 2016 (zatím nedohledáno), srpen 2019, 2/2011 a 3/2011 (ve zdrojové kopii je pod únorem duplicitně uložené lednové číslo, ne skutečné vydání), 10/2009 a 11–12/2010; 9/2010 je dochované jen jako neúplný 4stránkový výřez bez titulní strany. přiznaná mezera
noviny/Data/, ne na pecky.cz.
2019
2018
2017
2016
2015
2014
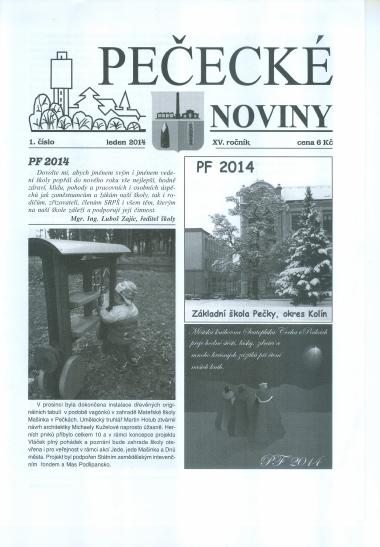
2013
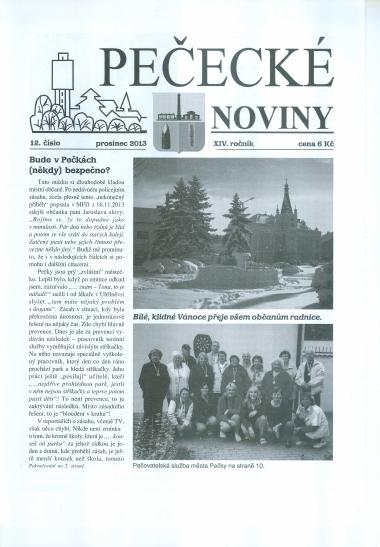
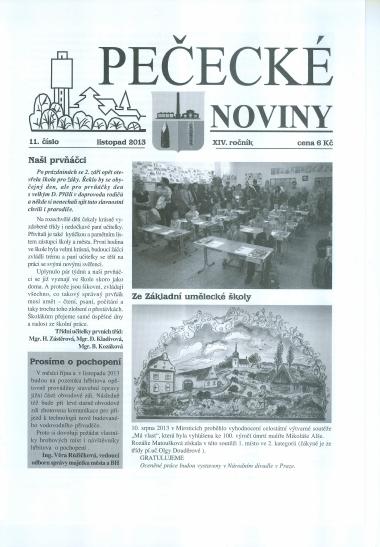
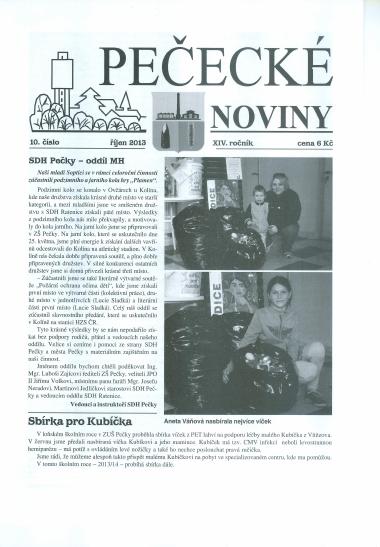
2012
2011
2010
2009
2008
2006
2005
2001
Pečecké noviny jsou informační měsíčník města — vychází měsíčně (mimo prázdninové dvojčíslo červenec–srpen) v nákladu cca 1 000 kusů, redakci vede Alena Brantová (noviny@pecky.cz). Archiv 2001, 2005–2026, 205 vydání (68 zrcadleno z pecky.cz, 137 z lokálního archivu — 2001, 2005–2006, 2008–2019). ověřeno
Přehled mezer v archivu
Souhrn všech chybějících čísel napříč celým archivem 2001, 2005–2026, seřazeno podle ročníku. Ročníky, které tu nejsou uvedené, jsou kompletní.
- 2002–2004: celé tři ročníky chybí — nedohledány ani v online archivu pecky.cz, ani v žádné poskytnuté lokální kopii
- 2001: dochoval se jen červen, a to jen jako 1stránkové torzo (titulní strana) — zbytek roku nedohledán
- 2005: dochovalo se jen dvojčíslo červenec–srpen — zbytek roku nedohledán
- 2006: dochovaly se jen leden (bez titulní strany), únor a březen — duben–prosinec nedohledány
- 2009: říjen
- 2010: listopad, prosinec
- 2011: únor, březen
- 2012: listopad
- 2015: srpen
- 2016: leden
- 2019: srpen
- 2020: srpen
- 2022: listopad, prosinec
- 2023: leden, únor
- 2025: leden
Rok 2026 průběžně pokračuje (zatím vydáno do čísla červenec–srpen) — chybějící pozdější měsíce nejsou mezera, ještě nevyšly. U vydání 2001-06 a 2006-01 (dohromady 8 stran) byl extrahovaný text z PDF nepoužitelný (poškozené vlastní kódování fontů z tehdejšího DTP softwaru) — fulltext pro tato dvě čísla proto pochází z OCR (Tesseract, čeština), ne z přímé extrakce jako zbytek archivu; ojedinělá chyba rozpoznání v hustě sázených tabulkách je proto pravděpodobnější než jinde. Celý ročník 2012–2015 (44 vydání) jsou čisté naskenované obrázky bez textové vrstvy — fulltext pro celou tuhle dávku proto pochází z OCR stejně jako u zmíněných dvou čísel.